CloudGPU nos dio crédito para hacer estas pruebas en sus GPUs. Lee la nota de patrocinio al final.
En septiembre medimos en nuestra RTX 3090 tres trucos de velocidad para MiniMax H3 en ComfyUI: Sage Attention, Sol-Attn de Kijai y el latent upscale en dos pasadas. La pregunta obvia era cuánto cambian esas cifras en una RTX 4090 y en una RTX 5090. Alquilamos las dos en CloudGPU, lanzamos el mismo script con el mismo prompt y la misma seed, y repetimos cada configuración tres veces. Para que la comparación fuera limpia, volvimos a medir también nuestra 3090 con el mismo software que las alquiladas. Aquí van los tiempos tal cual salieron, junto con dos cosas que no esperábamos.
De un vistazo
| Aspecto | Detalles |
|---|---|
| Modelo | MiniMax H3 INT8 ConvRot + LoRA turbo de 4 pasos (Comfy-Org / lightx2v) |
| GPUs | RTX 5090 32 GB y RTX 4090 24 GB alquiladas en CloudGPU, y nuestra RTX 3090 24 GB |
| Clip | 736x416, 294 fotogramas (12,25 s a 24 fps), seed 777 |
| Repeticiones | 3 por configuración, intercaladas; publicamos la mediana |
| Más rápido | Sage + Sol-Attn: 26,1 s en la 5090, 38,0 s en la 4090 y 70,5 s en la 3090 (−37 %, −36 % y −40 %) |
| Sorpresa 1 | Sol-Attn cambia la composición del vídeo con la misma seed |
| Sorpresa 2 | El upscale sin tiles duplicó al zorro en 2 de 12 clips (4 seeds × 3 tarjetas) |
| Coste total de las pruebas | 0,88 $ de alquiler de GPU (la 3090 es nuestra) |
Método: el mismo script que en la 3090
Usamos sin cambios el script de la prueba del 3 de septiembre, que monta el grafo de ComfyUI y lo envía por la API. El prompt es el mismo zorro corriendo por un bosque nevado:
Tracking shot of a red fox sprinting through a snowy pine forest at dawn, powder snow
kicking up behind its paws, low morning mist between the trees, warm sun rays cutting
through fog, frost on branches, photorealistic wildlife cinematography, shallow depth
of field, natural sound of snow crunching and wind through pines.
Resolución 736x416, 294 fotogramas, sampler euler, scheduler simple, 4 pasos, LoRA turbo con strength 1 y seed 777. Las tres configuraciones son:
- T1: atención por defecto de PyTorch.
- T2: + Sage Attention (
PathchSageAttentionKJ, modoauto). - T3: + Sage Attention en los bloques 0-2 y Sol-Attn en el resto (
tau=1.3,int8_qkeint8_pvactivados).
En cada GPU hicimos primero una pasada de calentamiento con T3, que carga el modelo y compila el kernel de Triton de Sol-Attn. No cuenta para la tabla. Después lanzamos T1, T2 y T3 intercalados, tres veces cada uno. El tiempo es el de ejecución en el servidor, sacado del historial de ComfyUI. Los loaders y el text encoder salen de caché igual que en la 3090, y comprobamos en cada una de las 9 pasadas por GPU que el sampler se ejecutaba de verdad y no salía de caché.
Software en las dos máquinas alquiladas: ComfyUI 0.36.0, torch 2.10.0+cu130, Triton 3.6.0, sageattention 1.0.6 (la misma versión que en la 3090), ComfyUI-SolAttn_triton dfc2e31 y ComfyUI-KJNodes 3f20054. Driver 610.57.
En la 3090 montamos una instalación aparte de ComfyUI con exactamente esas versiones y los mismos commits de nodos, porque la nuestra del 3 de septiembre era más nueva (ComfyUI 0.34.2, torch 2.12.1, Triton 3.7.1). Así las tres tarjetas corren el mismo software.
Resultados: Sage Attention y Sol-Attn
Mediana de 3 pasadas, en segundos de servidor (entre paréntesis, la pasada más rápida y la más lenta):
| Configuración | RTX 5090 32 GB | RTX 4090 24 GB | RTX 3090 24 GB* |
|---|---|---|---|
| T1 atención por defecto | 41,3 s (40,7-41,3) | 59,1 s (58,8-59,1) | 118,4 s (117,7-239,4) |
| T2 + Sage Attention | 33,3 s (32,6-33,7), −19 % | 46,9 s (46,9-47,0), −21 % | 88,8 s (87,8-97,2), −25 % |
| T3 + Sage + Sol-Attn | 26,1 s (25,9-26,5), −37 % | 38,0 s (38,0-38,0), −36 % | 70,5 s (68,4-76,0), −40 % |
* La 3090 es la nuestra, con el mismo software que las alquiladas. El 3 de septiembre, con el software anterior y una sola pasada, nos dio 129,1 / 94,4 / 78,0 s.
👉 Lo que importa: la mejora relativa de cada truco se mantiene en las tres generaciones de GPU. Sage Attention quita entre una quinta y una cuarta parte del tiempo, y sumarle Sol-Attn deja el render en algo menos de dos tercios. En la 5090, un clip de 12,25 s sale en 26 segundos; en la 3090, en 70.
La variación entre repeticiones fue mínima en las alquiladas: como mucho 1,1 s en la 5090 y 0,3 s en la 4090. En la 3090 la primera pasada de cada configuración salió más lenta (la de T1, 239 s, es un caso extremo), pero las otras dos quedaron a menos de 2 s entre sí, y por eso damos la mediana. Con tres pasadas por configuración, las diferencias de la tabla no son ruido.
RTX 5090 con Sage Attention + Sol-Attn: 26,5 s de render para 12,25 s de vídeo en esta pasada.
Sorpresa 1: Sol-Attn no da el mismo vídeo
En la 3090 solo comparamos un fotograma y nos pareció que Sol-Attn daba prácticamente lo mismo que Sage. Esta vez revisamos 9 fotogramas repartidos por cada clip, y la conclusión cambia. T1 y T2 son casi idénticos, pero T3 es otra toma: el zorro aparece más cerca, la cámara va más baja y los árboles son otros. Pasa igual en la 4090 y en la 5090.
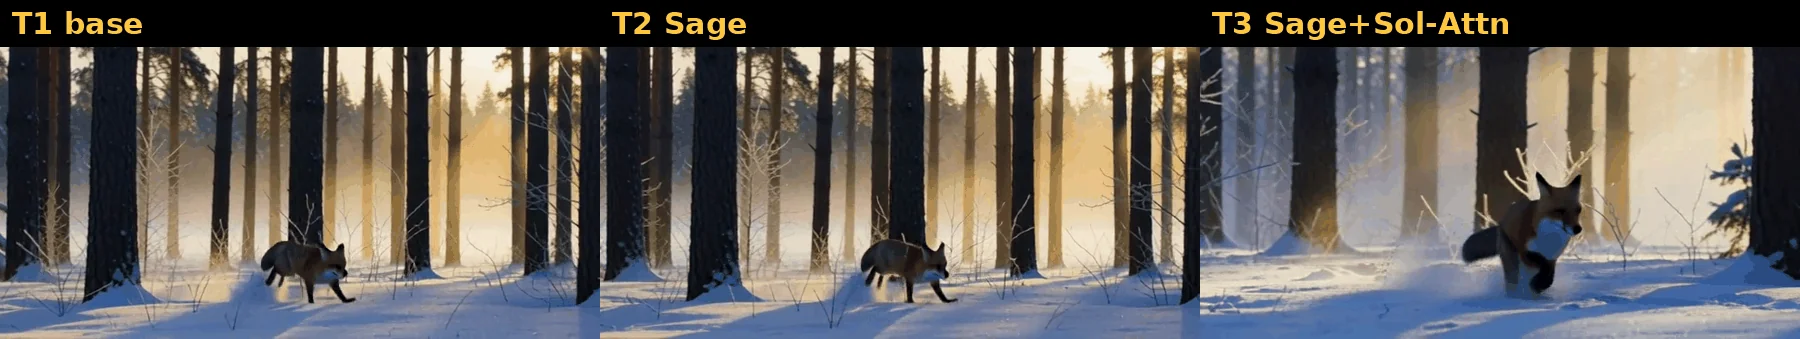
Fotograma 150 en la RTX 5090, misma seed: T1 (base), T2 (Sage) y T3 (Sage + Sol-Attn).
La calidad de T3 sigue siendo buena: no vimos deformaciones, duplicados ni artefactos en ninguno de los fotogramas revisados. Pero Sol-Attn aproxima parte de la atención, y en un modelo de vídeo eso basta para que la misma seed lleve a otro sitio. Si estás iterando sobre una seed que te gusta, no actives Sol-Attn a mitad del proceso: decide antes con qué atención vas a trabajar.
Otro detalle: con la misma seed, la 4090 y la 5090 dan la misma escena a grandes rasgos, pero no idéntica píxel a píxel. Dentro de cada tarjeta, las repeticiones sí salen iguales.
Sorpresa 2: el upscale sin tiles también duplica
En la prueba de la 3090 vimos que el latent upscale en dos pasadas podía duplicar al zorro si se partía el fotograma en tiles. La única configuración que nos salió limpia fue sin partición: un solo tile de 1344x768. Repetimos exactamente esa configuración (base 736x416 → 1344x768, fade de 128, seeds 777/778) en las dos GPUs alquiladas y en nuestra 3090 con el software nuevo:
| GPU | Tiempo total (2 pasadas) | Resultado |
|---|---|---|
| RTX 5090 | 218,5 s | Segundo zorro entre los fotogramas 140 y 152 |
| RTX 4090 | 325,3 s | Un solo zorro en todo el clip |
| RTX 3090 | no comparable* | Un solo zorro: sale de cuadro y vuelve a entrar |
* En nuestra 3090 cada upscale tardó unos 25 minutos, frente a 325 s en la 4090. Lo más probable es la RAM del PC: tiene 32 GB, durante el upscale quedaban unos 2 GB libres, y las máquinas alquiladas tenían 64 GB. Ese tiempo no sirve para comparar tarjetas. Para ver si el zorro se duplica, sí.
Para saber si era mala suerte, repetimos el upscale en las tres tarjetas con tres seeds más, revisando cada clip entero de 4 en 4 fotogramas:
| Seed | RTX 5090 | RTX 4090 | RTX 3090 |
|---|---|---|---|
| 777 (la de arriba) | Segundo zorro (218,5 s) | Limpio (325,3 s) | Limpio |
| 101 | Limpio (220,2 s) | Limpio (325,7 s) | Segundo zorro desde el fotograma 244 |
| 202 | Limpio (227,6 s) | Limpio (340,7 s) | Limpio |
| 303 | Limpio (229,1 s) | Limpio (342,2 s) | Limpio |
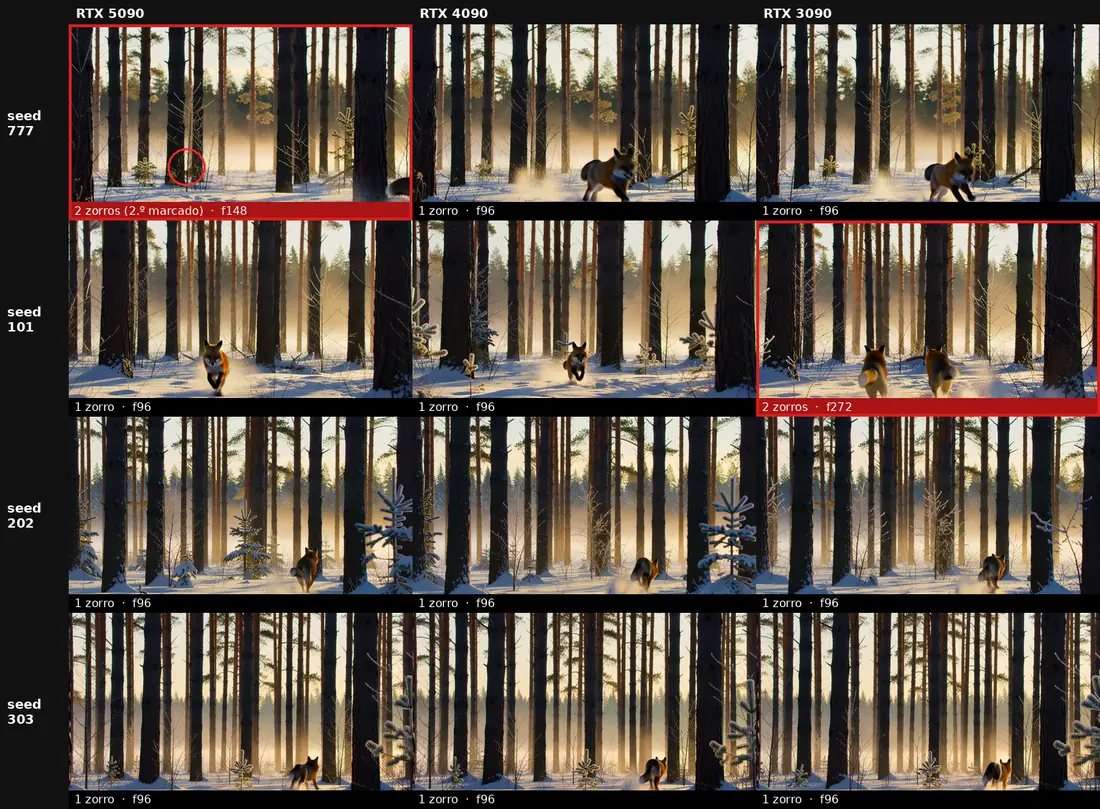
Un fotograma de cada uno de los 12 clips. En rojo, los dos que duplican al zorro.
Duplica en 2 de los 12 clips, y nunca en la misma combinación: la 5090 falla con la seed 777 y la 3090 con la 101, mientras que la 4090 sale limpia con las cuatro. No es sistemático, pero tampoco raro: con 2 de 12 clips estropeados, revisar el clip es obligatorio.
En la 5090, mientras el zorro original sale por la derecha en primer plano, aparece otro detrás de un tronco, en el centro de la imagen. Durante medio segundo se ven los dos a la vez, y el segundo se queda cruzando el fondo hasta el final del clip. Es pequeño y en miniatura casi no se ve, así que lo comprobamos fotograma a fotograma a resolución completa.
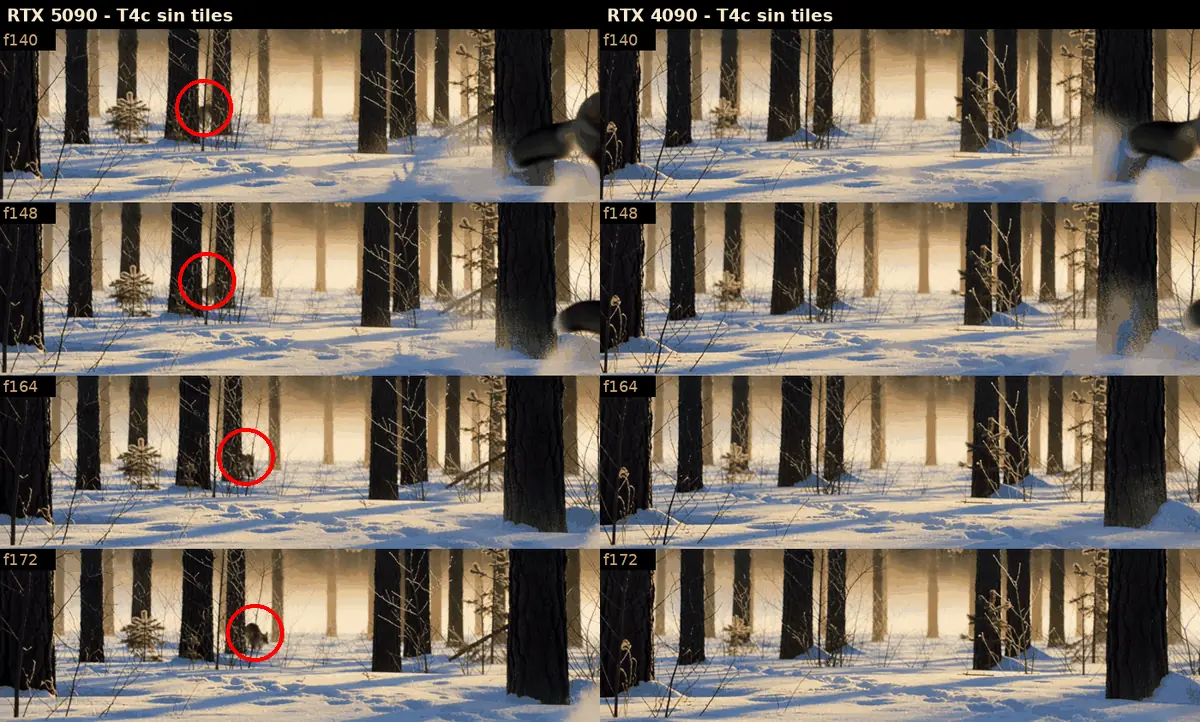
Upscale sin tiles, fotogramas 140 a 172: RTX 5090 a la izquierda (segundo zorro en el círculo) y RTX 4090 a la derecha.
El clip completo de la RTX 5090 tras el upscale. El segundo zorro aparece hacia el segundo 6.
Lo que sabemos y lo que no:
- No parece un defecto de una tarjeta concreta. Con la misma seed, cada tarjeta da la misma escena pero con diferencias visibles píxel a píxel (lo vimos también en T1-T3), y eso puede bastar para que el upscale caiga o no en el duplicado. La 5090 y la 3090 fallan cada una con una seed distinta y salen limpias con las otras tres, así que lo más probable es que el fallo vaya con la combinación de seed y tarjeta. Que la 4090 saliera limpia en las cuatro, con tan pocas muestras, puede ser suerte.
- El pase base estaba limpio en todos los clips: un solo zorro que la cámara sigue todo el rato. El duplicado lo introduce la segunda pasada, que vuelve a muestrear con denoise 1.0 y cambia la acción, no solo la resolución. En los 12 clips la acción del upscale es distinta de la del pase base: el zorro sale de cuadro, se esconde tras un tronco o da la vuelta.
- Puede tener que ver con el cambio de bloque. El nodo procesa el clip en bloques de 136 fotogramas con 17 de solape (solapes en 119-135 y 238-254). En la 5090 el segundo zorro aparece hacia el fotograma 140, justo después del primer solape, y en la 3090 hacia el 244, dentro del segundo. No es la misma posición, pero en los dos casos está cerca de un cambio de bloque. Con dos casos no lo podemos confirmar.
- La 4090 tampoco es perfecta: con la seed 777 el zorro sale de cuadro hacia el fotograma 152 y vuelve a entrar hacia el 245, y la 3090 hace lo mismo. No hay dos a la vez, pero la acción ya no es la del pase base.
👉 La regla práctica corregida: quitar los tiles reduce la duplicación, pero no la elimina. En septiembre revisamos 9 fotogramas de la 3090 y salió limpio, pero el fallo puede durar medio segundo y es fácil saltárselo. Si el upscale es para algo que vas a publicar, revisa el clip entero a resolución completa.
Un dato que hay que leer con cuidado: no encontramos el número de pasos que usamos en la segunda pasada el 3 de septiembre, así que aquí usamos 4 en la base y 4 en el upscale.
Coste real por clip
Precios de CloudGPU el 27/10/2026: RTX 5090 a 0,59 $/h y RTX 4090 a 0,33 $/h, facturados por minuto. Solo en tiempo de GPU:
| RTX 5090 | RTX 4090 | |
|---|---|---|
| Clip con Sage + Sol-Attn (T3) | 26,1 s ≈ 0,0043 $ | 38,0 s ≈ 0,0035 $ |
| Clip con upscale sin tiles (T4c) | 218,5 s ≈ 0,036 $ | 325,3 s ≈ 0,030 $ |
La 5090 tarda un 31 % menos, pero la 4090 sale algo más barata por clip. Ojo: esas cifras son solo el render; el coste real lo marca el tiempo de montar la máquina. Cada sesión entera (arranque, instalar los nodos, calentar y las 11 generaciones) nos costó 0,22 $ en la 5090 (22 minutos) y 0,13 $ en la 4090. No tuvimos que descargar los ~56 GB de modelos: la plantilla de ComfyUI de CloudGPU tiene una biblioteca de modelos de solo lectura y los ficheros exactos de Comfy-Org ya estaban ahí. En la 4090 faltaba la LoRA turbo en esa carpeta, así que la cogimos del repo de lightx2v, tras comprobar con sha256 que es idéntica byte a byte.
Sobre la VRAM no damos cifras esta vez. ComfyUI 0.36 reserva la memoria de forma dinámica y llena casi toda la tarjeta en todas las pruebas (31,8 GB de 32 en la 5090 y 24,1 de 24 en la 4090), así que el pico de nvidia-smi no dice cuánta hace falta de verdad. Lo único que podemos afirmar es que ninguna configuración se quedó sin memoria en 24 GB.
Limitaciones de esta prueba
- Un solo prompt. Tres repeticiones por configuración en T1-T3 con una seed. El upscale sin tiles se probó con 4 seeds en cada tarjeta: 12 clips no bastan para dar una tasa de fallo por tarjeta.
- La 3090 corrió en nuestro PC y no en la nube: solo 32 GB de RAM, lo que hace su upscale mucho más lento y no comparable.
- Los pasos del upscale (4 + 4) son una suposición: no constan los de la prueba original.
- Las GPUs alquiladas estaban en China (Nanjing y Wujiaqu). Como los modelos ya estaban en la máquina, eso no afecta al tiempo de render, pero sí a lo que tarda en bajar cualquier nodo de GitHub.
- No medimos la VRAM necesaria por configuración (ver arriba).
Conclusión
Sage Attention y Sol-Attn aceleran MiniMax H3 en una RTX 4090 y en una RTX 5090 en la misma proporción que en una 3090: alrededor de un 20 % con Sage y algo más de un 35 % con las dos. En una 5090 eso deja un clip de 12 segundos en 26 segundos de render. Lo que cambia respecto a lo que contamos en septiembre son dos matices. Sol-Attn no te da la misma toma con la misma seed, y el latent upscale sin tiles no está a salvo de duplicar al sujeto.
🏆 Nuestra recomendación
Activa Sage Attention siempre: es gratis en calidad y quita una quinta parte del tiempo. Usa Sol-Attn para explorar ideas rápido, pero decide antes de fijar la seed, porque la toma cambia. Para el upscale en dos pasadas, revisa el clip entero antes de darlo por bueno, con o sin tiles. Entre una 4090 y una 5090 alquiladas, la 5090 te ahorra tiempo de espera y la 4090 un poco de dinero por clip.
Nota de patrocinio
CloudGPU nos dio crédito para hacer estas pruebas, y con él alquilamos la 4090 y la 5090. La 3090 es nuestra. El botón de arriba es nuestro enlace de referido: si te registras desde él, podemos recibir una compensación. CloudGPU no ha revisado ni aprobado este artículo antes de publicarse. Las cifras son las que medimos, incluido el fallo del upscale en su RTX 5090.
Sigue leyendo
La prueba original en RTX 3090, con el bug de los tiles explicado paso a paso, está en MiniMax H3: Sage Attention, Sol-Attn y latent upscale en RTX 3090. Si buscas acelerar con otra LoRA, comparamos la PDD Acc de 8 pasos con la turbo de 4 pasos. Y para técnicas generales de velocidad en ComfyUI, tienes nuestra guía de cómo acelerar la generación en ComfyUI.
Siguientes pasos en ComfyUI
Primeros pasos
Más workflows de vídeo e imagen IA
Preguntas frecuentes
- ¿Cuánto tarda MiniMax H3 en una RTX 4090 y en una RTX 5090?
- Con nuestro grafo (INT8 ConvRot, LoRA turbo de 4 pasos, 736x416, 294 fotogramas = 12,25 s de vídeo), la mediana de 3 pasadas fue de 41,3 s en la RTX 5090, 59,1 s en la RTX 4090 y 118,4 s en la RTX 3090 con la atención por defecto. Con Sage Attention, 33,3 s, 46,9 s y 88,8 s. Con Sage + Sol-Attn, 26,1 s, 38,0 s y 70,5 s. Es tiempo de servidor con los modelos ya cargados y el texto ya codificado.
- ¿Sage Attention y Sol-Attn funcionan en RTX 4090 y RTX 5090?
- Sí, en las dos, con sageattention 1.0.6 y ComfyUI-SolAttn_triton (commit dfc2e31) sobre ComfyUI 0.36.0, torch 2.10 y Triton 3.6. Sol-Attn compila su kernel de Triton en la primera ejecución; esa primera pasada, con la carga del modelo incluida, tardó 98,5 s en la 5090 y 105,0 s en la 4090.
- ¿Sol-Attn cambia el resultado del vídeo?
- En nuestra prueba, sí. Con la misma seed, Sage Attention da prácticamente el mismo vídeo que la atención por defecto, pero Sage + Sol-Attn da otra composición: el zorro sale más cerca, la cámara más baja y cambian los árboles. La calidad sigue siendo buena y no vimos artefactos, pero no es la misma toma más rápida. Si tienes una seed que te gusta, Sol-Attn te la va a cambiar.
- ¿Merece la pena la RTX 5090 frente a la RTX 4090 para MiniMax H3?
- Tarda un 31 % menos en nuestra prueba (26,1 s frente a 38,0 s con Sage + Sol-Attn), pero a los precios de CloudGPU del 27/10/2026 (0,59 $/h frente a 0,33 $/h) cada clip sale algo más barato en la 4090: unos 0,0035 $ frente a 0,0043 $ de tiempo de GPU. La 5090 tiene además 32 GB de VRAM, que dan margen para resoluciones más altas.
- ¿El latent upscale sin tiles evita que se duplique el sujeto?
- No siempre. Probamos 4 seeds en RTX 5090, RTX 4090 y RTX 3090, revisando cada clip entero, y el zorro se duplicó en 2 de los 12 clips: en la 5090 con la seed 777 y en la 3090 con la seed 101. La 4090 salió limpia con las 4. El pase base a baja resolución estaba limpio en todos, así que lo introduce la segunda pasada del upscale. Quitar los tiles reduce el problema, pero no lo elimina.