El fotograma inicial fija de dónde parte el plano. El final tiene que ser alcanzable con la acción y la cámara que describe el prompt. Si entre los dos extremos cambias el gesto, el encuadre y la luz a la vez, luego no sabrás qué provocó un salto. Así que hicimos la prueba más simple posible: mismo inicio, mismo prompt, mismo seed y dos finales distintos, en nuestra RTX 3090 el 15 de noviembre de 2026.
Primero, el nodo correcto
En ComfyUI v0.34.2 no hay un nodo MiniMaxH3FirstLastFrameToVideo. Los extremos se pasan a MiniMaxH3ImageToVideo, que tiene dos entradas opcionales de imagen: first_frame y last_frame. Lo comprobamos en el código del núcleo (comfy_extras/nodes_minimax_h3.py) y preguntando al servidor por /object_info/MiniMaxH3ImageToVideo. En el código, el primer fotograma se redimensiona sin recorte (si la proporción no coincide, se estira) y el último con recorte centrado, así que conviene que los dos tengan ya la proporción del vídeo.
Montaje de la prueba
| Dato | Valor |
|---|---|
| Hardware | RTX 3090 24 GB, 32 GB de RAM, pesos en disco mecánico |
| Software | ComfyUI v0.34.2 (commit 169fcf35), PyTorch 2.12.1+cu130, driver 620.70.06 |
| Modelo | minimax_h3_fl2va_pruned_int8_convrot + LoRA minimax_h3_fl2v_turbo_4step_v1.0_768p a 0,85 (Comfy-Org/MiniMax-H3) |
| Encoder | qwen3vl_32b_minimax_h3_int8_convrot |
| Muestreo | 6 pasos, euler / simple, BasicGuider, MiniMaxH3SigmaShift 12 / 3 |
| Clip | 832×576, 124 fotogramas a 24 fps (5,17 s), con audio |
| Seed | 20261115 en las dos variantes |
| Prompt | Cámara fija sobre trípode; cuatro amigos comen pasta; la mujer de la chaqueta vaquera levanta el tenedor y habla; ambiente de restaurante sin diálogo inteligible |
Los fotogramas salen de un clip anterior de H3 generado a partir de una imagen de Krea 2, recortados para quitar el fondo con texto:
- Inicio: primer fotograma de ese clip, recortado.
- Fin A: último fotograma del mismo clip con el mismo recorte. Es un final que la escena puede alcanzar sin mover la cámara.
- Fin B: el mismo instante, con un recorte más cerrado centrado en la mujer. Obliga a cambiar el encuadre, algo que el prompt no pide.
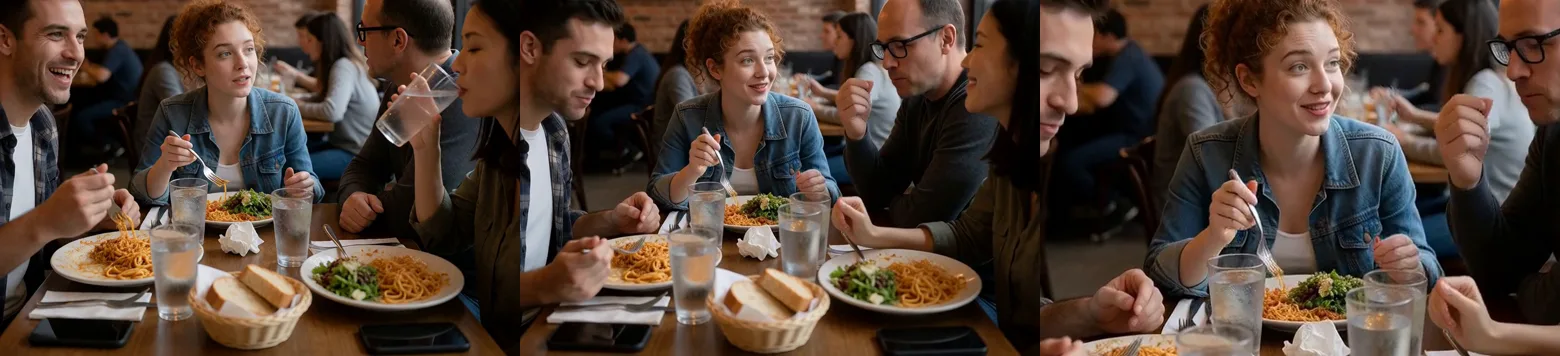
Es una sola ejecución por variante en una sola GPU: sirve para ver qué hace el modelo con este caso, no para medir una tasa de acierto.
Resultado A: mismo encuadre al final
El plano se mantiene estable de principio a fin. La mujer conserva cara, pelo y chaqueta, el fondo no se desplaza y el clip termina muy cerca del fotograma final que le dimos. Los gestos del resto de la mesa (beber, comer, gesticular) son plausibles.
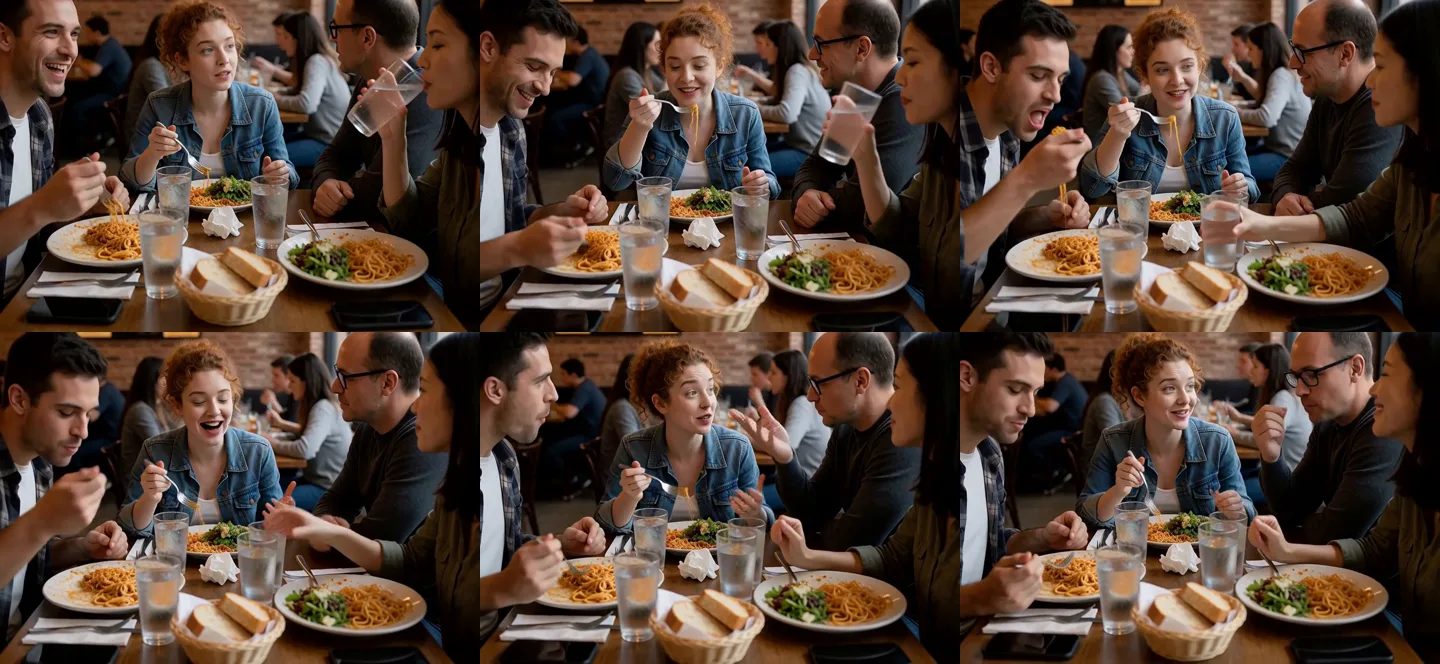
Resultado B: final con encuadre más cerrado
Hasta los 2,5 s la variante B es casi igual que la A: mismo seed, mismo inicio. Después, para llegar al final más cerrado, el modelo mete un acercamiento de cámara entre los fotogramas 66 y 90 (de 2,75 a 3,75 s), aunque el prompt pedía cámara fija. No es un corte: es un acercamiento continuo y rápido. Al final la mujer ocupa el centro del encuadre, como en el fotograma que le dimos, y su identidad se mantiene.
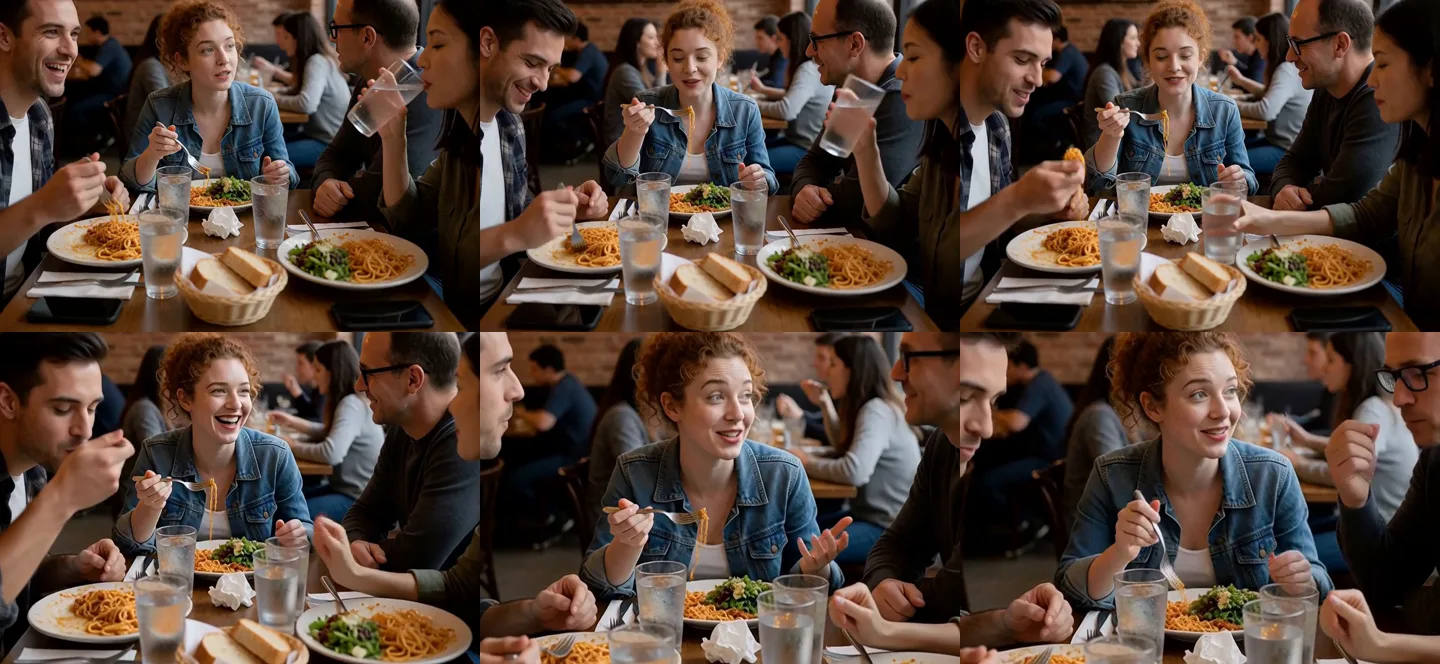
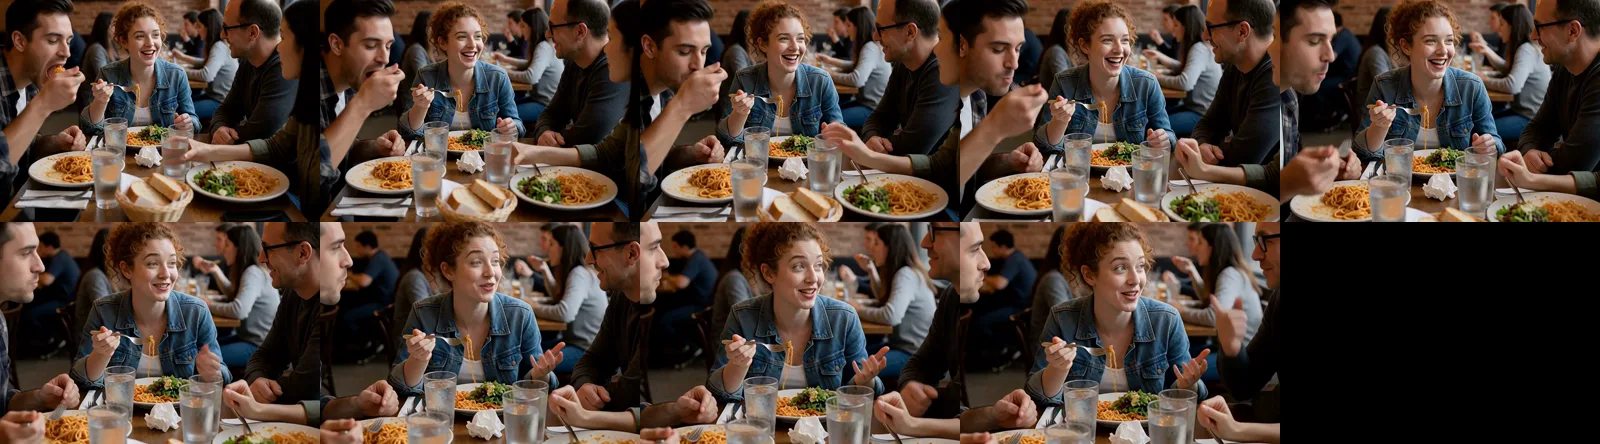
Para localizarlo sin depender del ojo medimos la diferencia media entre fotogramas consecutivos con ffmpeg (tblend=difference + signalstats, en gris y a 160 px de ancho). En A el valor máximo fue 5,1. En B los picos llegaron a 9,8, concentrados en los fotogramas 67-70 y 89-90: el principio y el final del acercamiento.
Tiempos y memoria
| Variante | Tiempo total | Pico de VRAM (GPU entera) |
|---|---|---|
| A (primera ejecución, en frío) | 39 min 35 s | 23,8 GB |
| B (segunda ejecución) | 24 min 24 s | 23,8 GB |
Estas cifras engañan si no se explican. Casi todo el tiempo fue cargar pesos: el encoder de 32B (unos 26 GB) y el modelo de vídeo (unos 20 GB) se leyeron desde un disco mecánico, y con 32 GB de RAM la caché no los retuvo entre ejecuciones. Según la barra de ComfyUI, la inicialización del modelo tardó 14 min 21 s en A y 11 min 33 s en B, y los seis pasos de muestreo de B, alrededor de un minuto. El pico de VRAM se leyó con nvidia-smi cada segundo e incluye unos 0,8 GB del escritorio; ComfyUI carga los pesos de forma dinámica hasta llenar la VRAM disponible, así que no es un requisito mínimo. Con los pesos en un SSD rápido y más RAM, el tiempo por clip debería bajar mucho, pero no lo hemos medido.
Qué sacamos de la prueba
- En esta prueba, el final más cerrado provocó un acercamiento pese al prompt de cámara fija.
- Para un plano quieto, prueba primero con el mismo encuadre al inicio y al final. Deja que cambie el gesto y conserva la escala.
- Si quieres un acercamiento, pídelo. Lo coherente con este resultado es describir el movimiento en el prompt y dejar que el final lo confirme. No lo probamos en esta tanda.
- Revisa siempre varios fotogramas. En B, el primer y el último fotograma parecen correctos; el movimiento no pedido solo aparece a mitad del clip.
Descarga y siguiente paso
El workflow en formato API incluye los nombres exactos de los modelos, el prompt y el seed de esta prueba. Necesita ComfyUI-VideoHelperSuite para guardar el MP4. Copia tus imágenes como inicio.png y fin.png y cambia solo fin.png para comparar.
Para secuencias de varios segmentos, la guía de Motion Director en RTX 3090 documenta otro flujo. Si el problema es mantener la identidad al cambiar de vista, compara con el flujo Ref2VA de MiniMax H3, que controla el sujeto con referencias en lugar de con fotogramas.
Siguientes pasos en ComfyUI
Primeros pasos
Más workflows de vídeo e imagen IA
Preguntas frecuentes
- ¿Qué nodo uso para fijar el primer y el último fotograma?
- En ComfyUI v0.34.2, MiniMaxH3ImageToVideo, que tiene dos entradas opcionales: first_frame y last_frame. Lo comprobamos en el código del núcleo (comfy_extras/nodes_minimax_h3.py) y en /object_info del servidor. No existe un nodo llamado MiniMaxH3FirstLastFrameToVideo en esa versión.
- ¿Qué variable cambio en la primera prueba?
- Solo el fotograma final. Mantén el primer fotograma, el prompt, el seed, la resolución, la duración y el grafo. Así cualquier diferencia entre las dos salidas se puede atribuir al último fotograma.
- ¿Qué pasa si el último fotograma tiene otro encuadre que el prompt no pide?
- En nuestra prueba el modelo priorizó llegar al fotograma final: con el prompt «cámara fija sobre trípode» y un final más cerrado, hizo un acercamiento rápido entre los fotogramas 66 y 90 en vez de mantener la cámara quieta. No fue un corte duro, pero sí el momento de más cambio entre fotogramas del clip.
- ¿Cuánto tarda y cuánta VRAM usa en una RTX 3090?
- La ejecución completa tardó 39 min 35 s en frío y 24 min 24 s en la segunda variante, pero casi todo fue cargar el encoder de 32B y el modelo desde un disco mecánico con 32 GB de RAM; los seis pasos de muestreo de la variante B tardaron alrededor de un minuto según la barra de ComfyUI. El pico de la GPU fue 23,8 GB, contando el escritorio, porque ComfyUI ocupa la VRAM disponible al cargar.
- ¿Cómo reviso si el personaje conserva la cara pero el plano salta?
- Extrae varios fotogramas repartidos por todo el clip, no solo el primero y el último, y compara fondo, escala y eje de cámara. Una medida rápida es la diferencia media entre fotogramas consecutivos con ffmpeg: un pico aislado señala dónde está el salto o el movimiento brusco.
- ¿Puedo descargar el workflow?
- Sí, en formato API de ComfyUI, con los nombres de los modelos y el prompt usados. Copia tus imágenes como inicio.png y fin.png en la carpeta input de ComfyUI y cambia solo fin.png para la segunda variante.